Ausgangssituation
Ein Versicherungsunternehmen entwickelt ein neues Online-Portal zur Schadenmeldung.
Die Kunden sollen einen Kfz-Schaden digital an die Versicherung melden können.
Der Prozess sieht vereinfacht so aus:
1. Kunde meldet einen Schaden.
2. Kunde lädt Fotos hoch.
3. Kunde gibt Schadenssumme an.
4. Der Schaden wird automatisiert bearbeitet.
5. Bei Beträgen unter 10.000,- €uro erfolgt eine automatische Freigabe.
Die Anforderungen wurden dokumentiert.
Das Unternehmen entscheidet:
„Wir setzen vollständig auf KI-gestützten Softwaretest.“
Schritt 1: KI generiert die Testfälle
Die KI analysiert die Spezifikation.
Sie erzeugt beispielsweise folgende Tests:
Eingabetest
• Schadenssumme = 100,- €uro
• Schadenssumme = 5.000,- €uro
• Schadenssumme = 9.999,- €uro
• Schadenssumme = 10.000,- €uro
• Schadenssumme = 10.001,- €uro
Dateiupload
• JPG-Datei
• PNG-Datei
• PDF-Datei
Pflichtfelder
• Name vorhanden
• Schadenstyp vorhanden
• Fahrzeugkennzeichen vorhanden
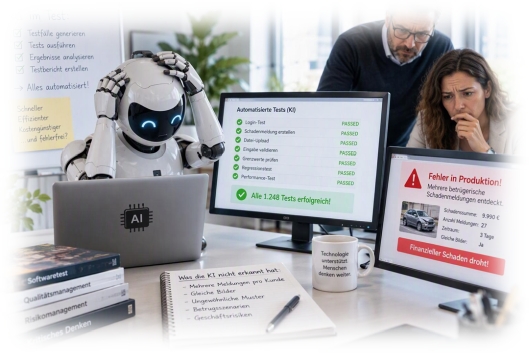
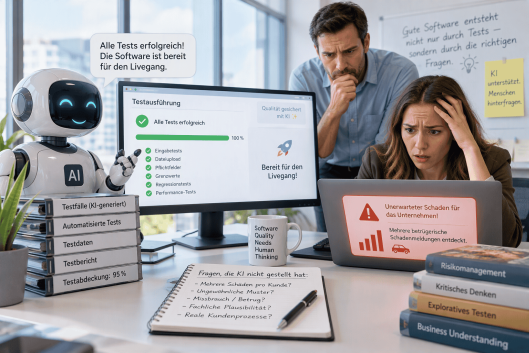
Die KI deckt die dokumentierten Anforderungen scheinbar hervorragend ab.
Alle Tests werden erfolgreich bestanden.
Das Projektteam ist begeistert.
Schritt 2: Das Produkt geht live
Nach wenigen Tagen tritt ein erhebliches Problem auf.
Ein Kunde meldet einen Schaden über 8.000,- €uro.
Der Schaden wird automatisch genehmigt.
Formal funktioniert alles korrekt.
Trotzdem entsteht ein finanzieller Schaden für das Unternehmen.
Warum?
Was die KI übersehen hat
Die fachlichen Experten wussten, dass Betrüger häufig Schäden knapp unter einer Prüfgrenze einreichen.
Genau deshalb hätten erfahrene Tester folgende Fragen gestellt:
• Was passiert bei mehreren Schadenmeldungen desselben Kunden?
• Was passiert bei wiederholten Schäden innerhalb kurzer Zeit?
• Was passiert bei ungewöhnlichen Mustern?
• Werden ähnliche Bilder mehrfach verwendet?
• Werden Standortdaten ausgewertet?
• Wird Missbrauch erkannt?
Diese Anforderungen standen jedoch nicht in der Spezifikation.
Folglich wurden sie von der KI auch nicht getestet.
Die menschliche Perspektive
Ein erfahrener
Tester denkt anders und betrachtet nicht nur die Anforderung.
Er betrachtet das Geschäftsrisiko. Dabei könnte er fragen:
„Wenn ich Betrüger wäre, wie würde ich dieses System austricksen?“
Daraus entstehen Tests wie:
Missbrauchsszenario 1
Gleicher Kunde meldet fünf Schäden innerhalb einer Woche.
Missbrauchsszenario 2
Mehrere Kunden nutzen identische Schadensbilder.
Missbrauchsszenario 3
Ungewöhnliche Schadenssummen von 9.990,- €uro.
Missbrauchsszenario 4
Automatisierte Masseneingaben über Bots.
Genau diese Szenarien findet eine KI häufig nicht, wenn sie nicht explizit beschrieben wurden.
Warum Anforderungen selbst fehlerhaft sein können
Eine weitere Schwäche zeigt sich bereits vor dem eigentlichen Test.
Nehmen wir folgende Anforderung:
"Schäden bis 10.000,- €uro werden automatisch genehmigt."
Eine KI erstellt daraus korrekte Testfälle.
Ein erfahrener
Tester oder Business Analyst erkennt jedoch sofort mögliche Fragen:
• Gilt dies für alle Fahrzeugklassen?
• Gibt es Ausnahmen?
• Gilt dies für Neukunden?
• Gilt dies für Firmenkunden?
• Gilt dies für Schadenshäufungen?
Die KI testet die Anforderung.
Der Mensch hinterfragt die Anforderung.
Das ist ein fundamentaler Unterschied.
Das Problem der Scheingenauigkeit
Ein weiteres Risiko besteht darin, dass KI sehr überzeugend wirkt.
Wenn eine KI meldet:
"95 % Testabdeckung erreicht."
klingt dies nach hoher Qualität.
Allerdings beschreibt Testabdeckung lediglich die Menge getesteter Aspekte.
Nicht getestet werden möglicherweise:
• Geschäftsrisiken
• Sicherheitslücken
• Prozessfehler
• Benutzerfreundlichkeit
• regulatorische Anforderungen
Ein Produkt kann eine Testabdeckung von 95 % besitzen und dennoch in Produktion scheitern.
Die Kennzahl erzeugt dann lediglich eine gefährliche Illusion von Sicherheit.
Exploratives Testen kann nicht vollständig automatisiert werden
Viele schwerwiegende Fehler werden nicht durch geplante Testfälle entdeckt.
Sie entstehen durch neugieriges Ausprobieren.
Ein erfahrener
Tester:
• kombiniert unerwartete Eingaben
• nutzt untypische Abläufe
• simuliert reale Anwender
• hinterfragt Ergebnisse
Beispielsweise könnte ein Tester zufällig bemerken, dass ein Kunde während der Schadenerfassung den Browser zurücksetzt, mehrere Tabs öffnet oder eine Sitzung mehrfach verwendet.
Solche Fehler entstehen häufig außerhalb dokumentierter Testfälle.
Menschen entdecken sie oft durch Erfahrung und Intuition.
Die Bedeutung von Kontextwissen
Software existiert niemals isoliert.
Sie wird genutzt von:
• Kunden
• Mitarbeitern
• Partnern
• Behörden
Ein
Tester kennt häufig:
• Unternehmensprozesse
• rechtliche Vorgaben
• Branchenbesonderheiten
• Kundenverhalten
KI kennt nur die Informationen, die ihr bereitgestellt wurden.
Fehlt Kontext, entstehen blinde Flecken.